Genie 4
北京时间10月28日,据科技网站TechCrunch报道,谷歌DeepMind在周二发布了其最新世界模型Genie 4的研究预览版。这一最新模型能够生成迄今最逼真、最具交互性的世界,允许用户在模拟过程中输入提示词来改变场景。该模型还能生成与模拟世界相匹配的实时音频,包括音乐、环境音效和交互式对话。
Genie 4是谷歌为了在竞争激烈的世界模型领域保持领先地位而采取的最新举措。就在Genie 4发布的几个月前,AI视频创业公司Runway推出了其第二款世界模型GWM Worlds 2。这是一款可交互的模型,能够根据用户输入动态作出响应,并具备音频生成功能。与此同时,世界模型行业开始出现整合趋势。李飞飞的World Labs正被AMD收购,亚马逊正在洽谈收购Decart,而Rivian刚刚收购了Third Dimension,以将模拟能力引入内部用于自动驾驶测试。
和谷歌一年前发布的上一代世界模型Genie 3相比,除了画面更加逼真并加入音频功能外,Genie 4还支持自由编辑,例如实时改变天气或摄像机角度,以及添加新人物或物体。它能够将一致的场景维持长达两分钟,是上一代模型的两倍,同时还具备更出色的物理模拟效果和更接近真人的角色。
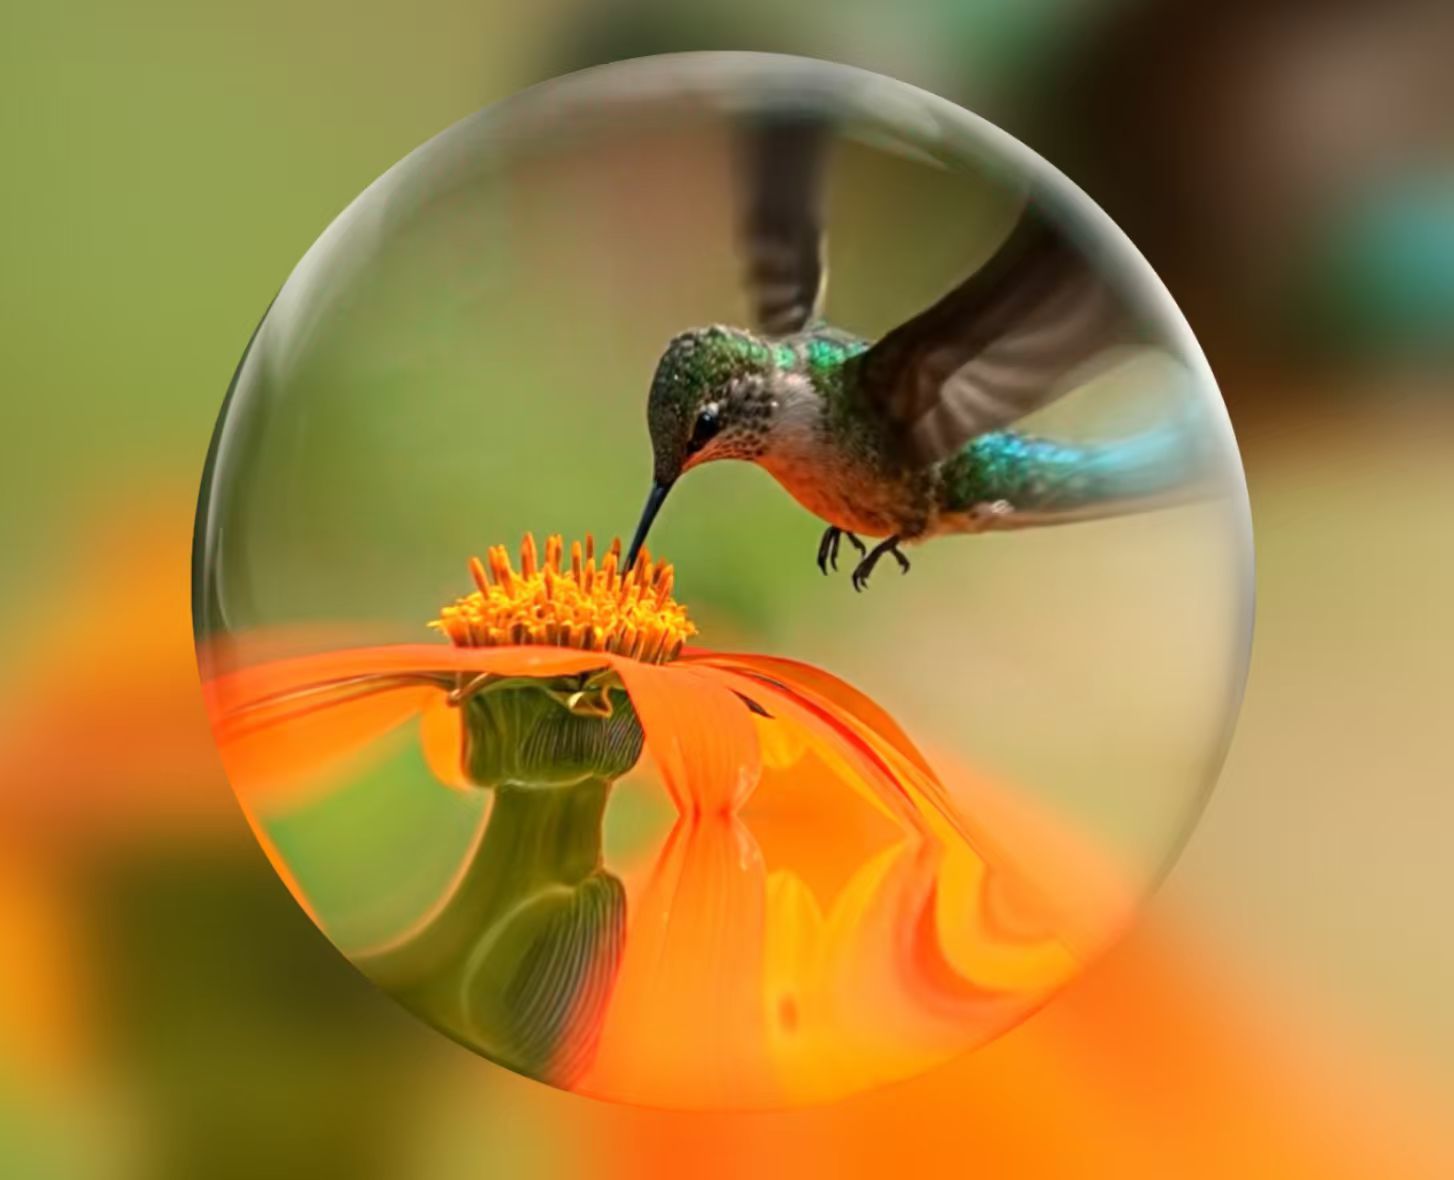
Genie 4生成画面更逼真
谷歌AI模型Gemini也与Genie 4实现了更紧密的整合。Gemini充当“导演”,负责规划步骤并检查画面,而Genie则负责生成视觉内容。在一项与Gemini Robotics相关的研究实验中,Gemini 4 Argon模型将任务分解为多个步骤,再由Genie 4进行实时模拟。这项实验展示了一种潜在的方法,即在机器人执行现实世界中的任务之前,先通过模拟环境测试相关场景。
“未来,我们将越来越多地看到这种混合式世界模型,将Gemini编写代码和文本的能力与Genie实时接收这些内容、并在不同抽象层次上模拟现实的能力结合起来。”谷歌研究总监特贾斯·库尔卡尼(Tejas Kulkarni)在一次媒体吹风会上表示。
与其他世界模型一样,Genie 4所瞄准的商业应用场景包括游戏、交互式学习和机器人技术。交互式学习的一种设想是,用户可以进入一幅描绘历史场景的画作,与画中人物交谈,了解画作所呈现的历史事件。
不过,首批获准体验谷歌前沿产品的“受信任测试人员”指出了另一种潜在用途:制作电影原型。
谷歌DeepMind工程师迭戈·里瓦斯(Diego Rivas)在媒体吹风会上表示:“实时功能最大的价值在于,它能让创作者保持流畅的创作状态。例如,在创意构思和故事板制作阶段,或者任何需要快速产生创意的场景中,这项功能都非常有用。”
谷歌还提供AI视频生成模型Veo,可以根据文本、图像或视频提示词生成带有同步音频的高清视频片段。这款工具正越来越受到电影制作人的欢迎。
里瓦斯补充说,未来用户或许可以借助Gemini Omni,将这些原型转化为可用于创作的素材。Gemini Omni是一款多模态大语言模型,能够根据图像、音频和文本生成视频。不过,他表示,实现这些功能仍需要一段时间。
在整场媒体吹风会上,里瓦斯反复强调,Genie 4仍处于早期发展阶段,最终的端到端产品体验会是什么样子,目前还不清楚。团队也承认,Genie 4仍存在一些不足:随着模拟运行时间延长,细节和物体可能出现偏移或变化。此外,团队尚未完全解决如何确保音频准确,以及虚拟世界中的文字清晰可读等问题。
Genie 4现已面向受信任的测试人员推出研究预览版。未来几周,该模型将通过Project Genie向Google AI Ultra订阅用户开放,同时也将向Gemini API和Google AI Studio的早期合作伙伴提供。Project Genie是谷歌推出的一款AI工具,可以根据文本或图像提示词生成可交互的虚拟世界。
【来源:凤凰网科技】