Gemini Omni 1.2 Flash
北京时间11月6日,谷歌公司在周四正式推出了视频生成模型Gemini Omni 1.2 Flash,该模型支持原生15秒视频生成,支持通过多轮对话进行编辑,价格较上一代降低30%。
谷歌表示,Gemini Omni 1.2 Flash正通过Gemini API、Google AI Studio、Google Cloud Console、Flow、Google Vids、面向Google AI Ultra订阅用户的Gemini应用以及Google Ads陆续推出。每个生成的视频都带有不可感知的SynthID水印,以标明其来源。
现在,该模型生成的视频片段时长可设定为3至15秒,此前最长为10秒。同时,720p视频的生成价格下调30%,降至每秒0.07美元。用户还可以通过持续对话的方式对已生成的视频进行编辑。
它的一项突出功能是谷歌所称的“对话式编辑”(Conversational Editing)。用户可以通过多轮对话逐步调整生成的视频,例如更换背景、调整光线或修改画面比例,而无需重新生成整个视频。谷歌表示,这项功能支持对完整的15秒视频进行编辑。
再结合上分层工作流,这项功能还有望降低生成成本。用户首先以360p或720p分辨率生成初稿,再通过后续编辑修正个别细节,最后仅对最终成片进行升频处理,将分辨率提升至1080p或4K。
谷歌还表示,模型对参考素材的遵循能力也有了显著提升。根据官方公告,用户可以输入人物形象图片、产品照片、最长3秒的短视频片段以及音频提示。模型能够在不同拍摄角度下,保持人物面部、服装、产品包装上的文字以及品牌配色的一致性。
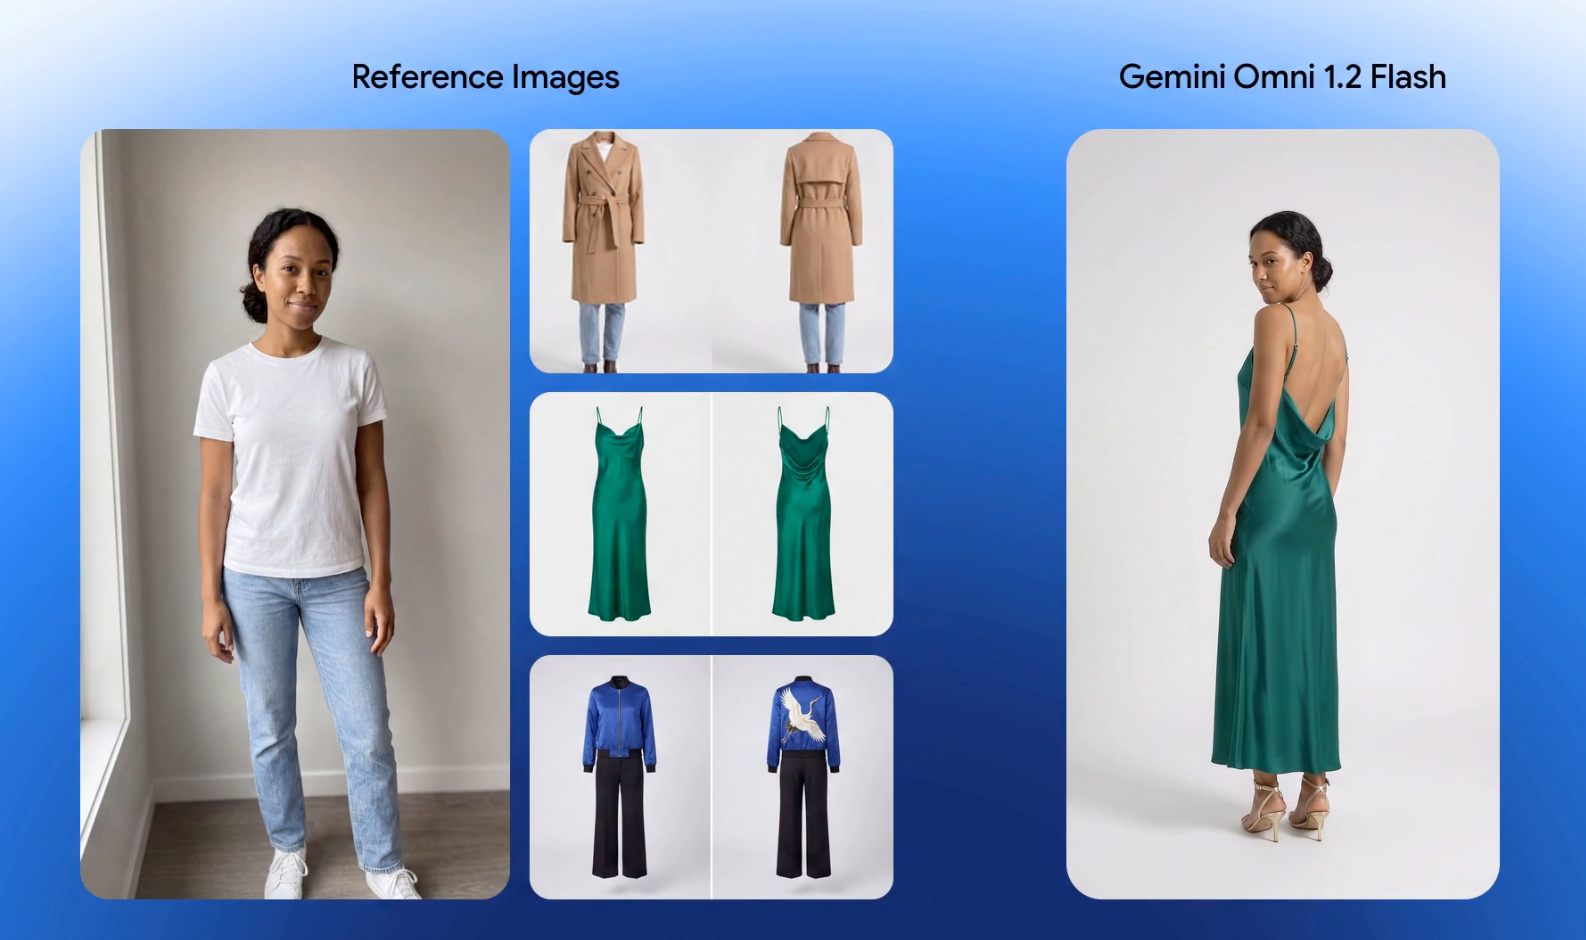
遵循素材能力显著提升
谷歌以一个虚拟试穿片段为例:仅凭一张模特照片和三套服装的产品图,该模型就能生成一段15 秒、包含360度转身的连续画面,同时保持模特身份以及每件服装的剪裁和垂坠感不变。
与此同时,整体视觉一致性也有所提升。谷歌表示,与上一代模型相比,新模型在画面运动和镜头切换过程中出现的视觉偏移和形变现象更少。
此外,Gemini Omni 1.2 Flash能够生成更加流畅、自然的对话语音,口型与语音的同步效果更加精准,同时还具备区分多个不同说话者的能力。
该模型还能够更好地处理复杂、连续的镜头运动,例如FPV无人机飞行镜头或具有强烈视觉冲击力的快速拉远镜头,并大幅减少不必要的跳切。
【来源:凤凰网科技】