2026年11月10日至14日,第34届ACM国际多媒体会议(ACM Multimedia 2026,简称ACM MM 2026)在巴西里约热内卢举行。中国科学技术大学与云知声智能科技有限公司的研究人员组成的联合团队,在会议同期举办的国际挑战赛中取得优异成绩,斩获一项最佳论文奖、三项冠军和一项亚军。相关获奖方案形成的4篇学术论文被ACM MM 2026录用发表。
MAC 2026:微动作分析双赛道夺冠,斩获最佳论文奖
在第三届微动作分析挑战赛(MAC 2026)中,由云知声研究人员与中国科大研究生组成的研究团队,在於俊副教授指导下,包揽微动作识别(Track 1)和多标签微动作检测(Track 2)两个赛道冠军,Track 1相关论文同时荣获挑战赛最佳论文奖。
针对微动作幅度弱、类别相似度高和长尾分布严重等问题,团队设计了层级软融合与候选标签重排序方案,以0.7999的F1mean成绩位列Track 1第一;针对未裁剪视频中多个微动作重叠出现的检测难题,团队提出时间适配器金字塔与跨层融合方法,以27.04%的平均mAP获得Track 2第一。
两个赛道的获奖方案分别形成论文《SoftRerank: Hierarchical Soft Fusion with Candidate Label Reranking for Long-Tailed Micro-Action Recognition》和《Temporal Adapter Pyramids with Cross-Layer Fusion for Multi-Label Micro-Action Detection》,均被ACM MM 2026录用发表。
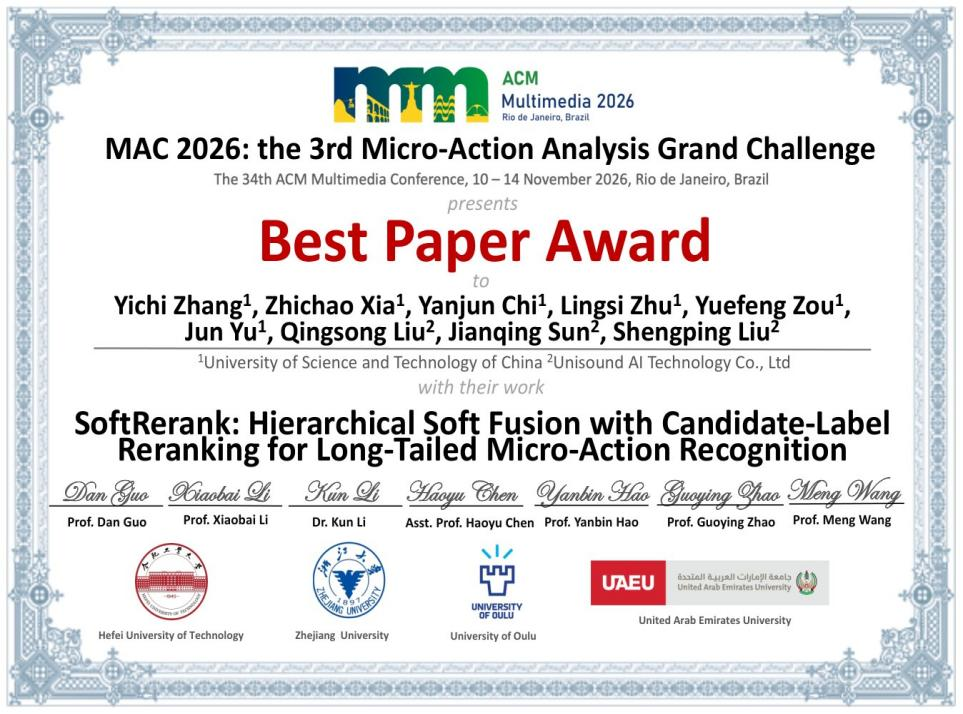
图1-MAC 2026 微动作分析挑战赛最佳论文奖证书
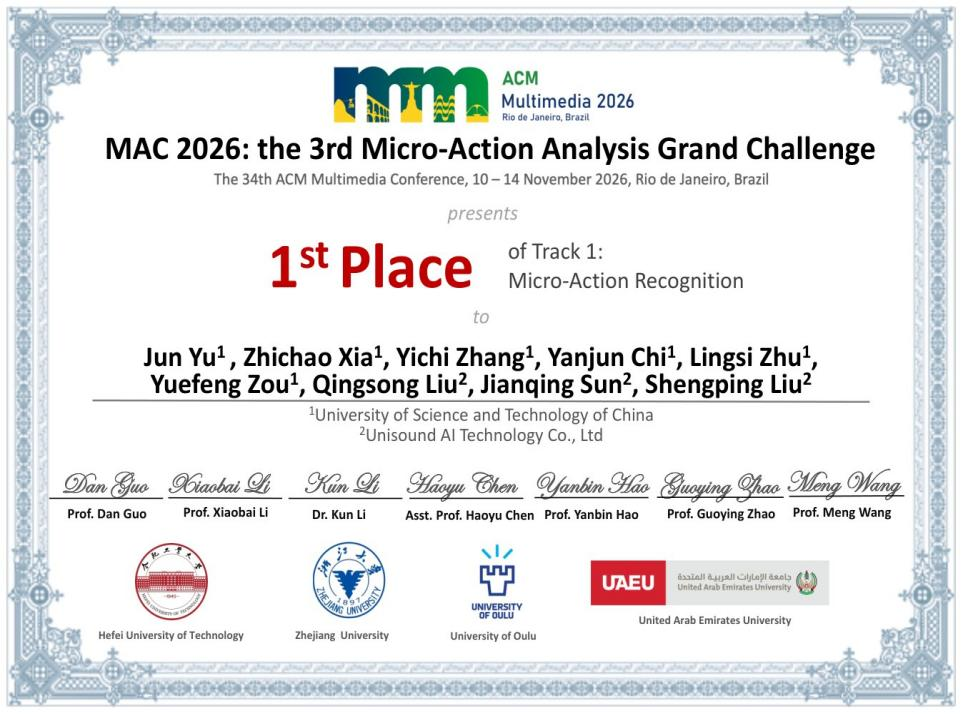
图2-MAC 2026 微动作识别(Track 1)赛道冠军证书
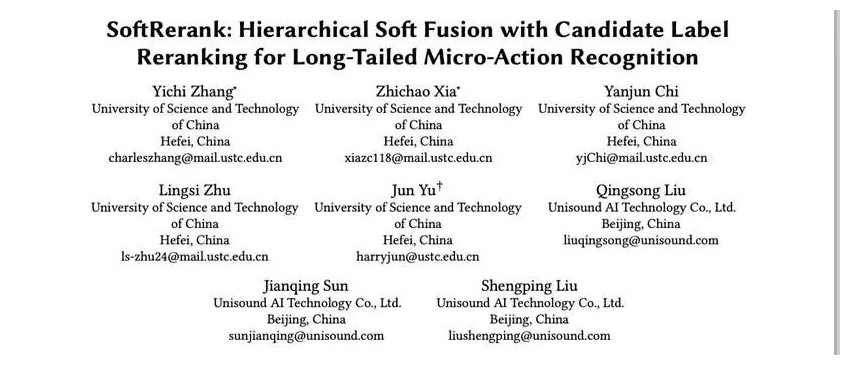
图3-论文首页:SoftRerank(MAC 2026 Track 1 冠军方案,同时获挑战赛最佳论文奖)
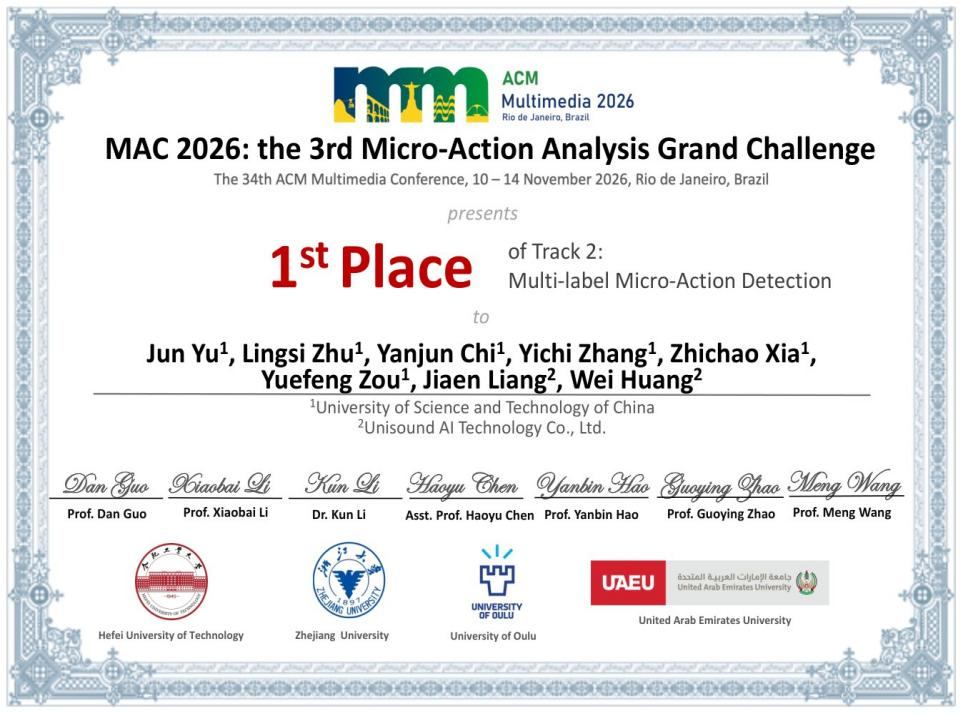
图4-MAC 2026 多标签微动作检测(Track 2)赛道冠军证书
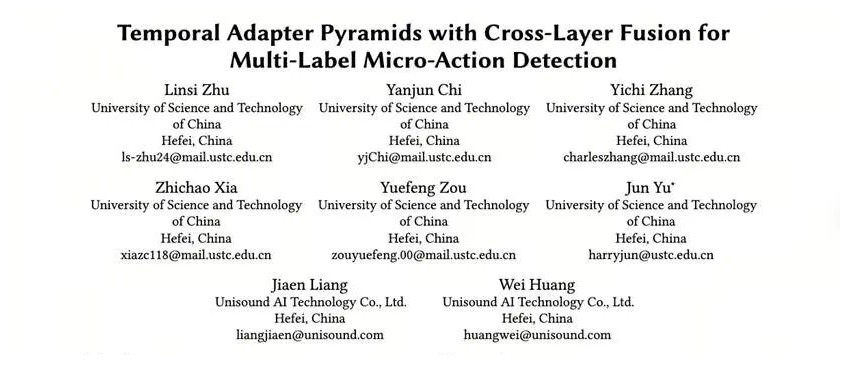
图5-论文首页:Temporal Adapter Pyramids(MAC 2026 Track 2 冠军方案)
LAVA 2026:多语言文档理解再突破,包揽挑战赛冠亚军
在大型视觉—语言模型学习与应用挑战赛(LAVA 2026)中,云知声研究人员与中国科大研究人员组成的两支团队分别获得冠军和亚军。该挑战赛面向日语、越南语等多语言、多页PDF文档,要求模型在给出答案的同时定位证据页,共吸引55支队伍参赛。
由云知声研究人员与於俊、刘冠钧、王柯等组成的U2lab-OCR队,提出页面级视觉检索与受控推理框架PageRAG-H,以0.8930的成绩获得冠军;由云知声研究人员与於俊、聂鸿等组成的USTC-IAT-United队,提出融合多层次文档解析与多智能体协同决策的视觉问答框架,并将高置信度决策蒸馏至轻量级模型,获得亚军。
冠军、亚军方案分别形成论文《PageRAG-H: Page-Level Visual Retrieval-Augmented Generation with Grounded Reasoning Harness for Multilingual PDF Question Answering》与《Hierarchical Document Parsing and Multi-Agent Collaborative Decision-Making for Long-Document Visual Question Answering》,均被ACM MM 2026录用发表。
从识别文字到理解文档,再到定位证据、回答问题,复杂文档处理对多模态理解能力提出了更高要求。此次LAVA挑战赛中涉及的文档解析、视觉检索和信息定位等研究方向,也与云知声U2-OCR的能力建设紧密相关。
目前,U2-OCR已具备文字识别、文档解析、结构化信息提取及文档智能问答能力。在近期评测中,U2-OCR登顶OCRBench v2中文榜单,并在MDPBench综合评测中位列第二,展现了对复杂文档的识别与理解能力。
在实际应用中,云知声持续推动多语言文档智能技术与医疗、医保业务融合,赋能医保结算清单抽取、智能审核等场景,提升复杂文档处理效率。
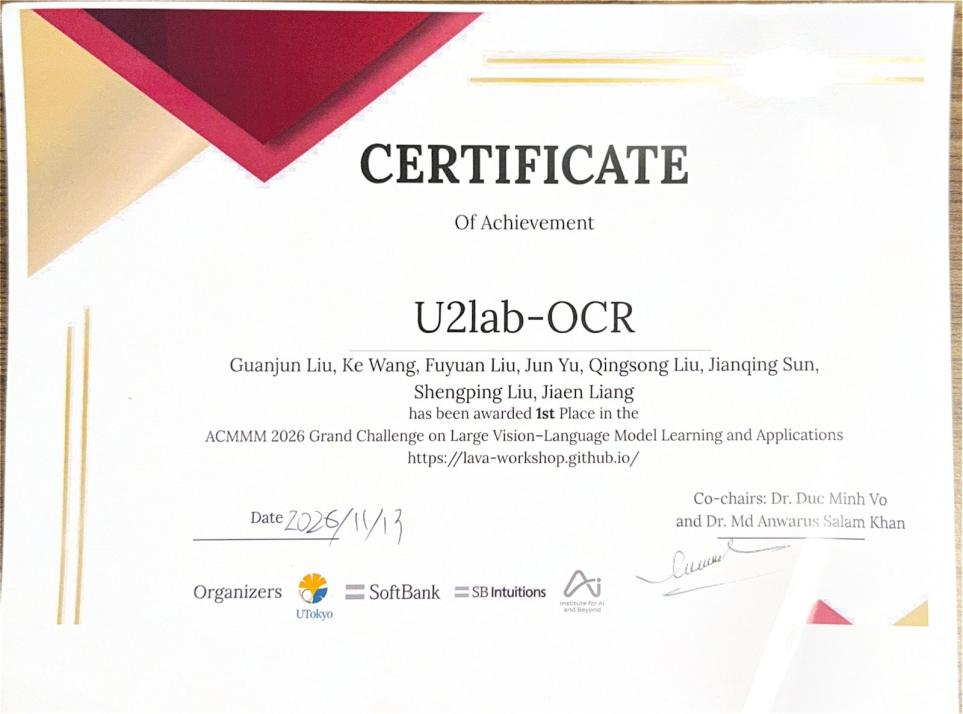
图6-LAVA 2026 挑战赛冠军证书(U2lab-OCR 队)
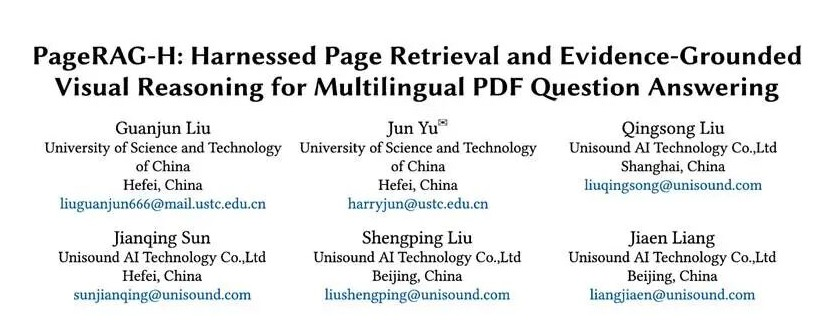
图7-论文首页:PageRAG-H(LAVA 2026 冠军方案)
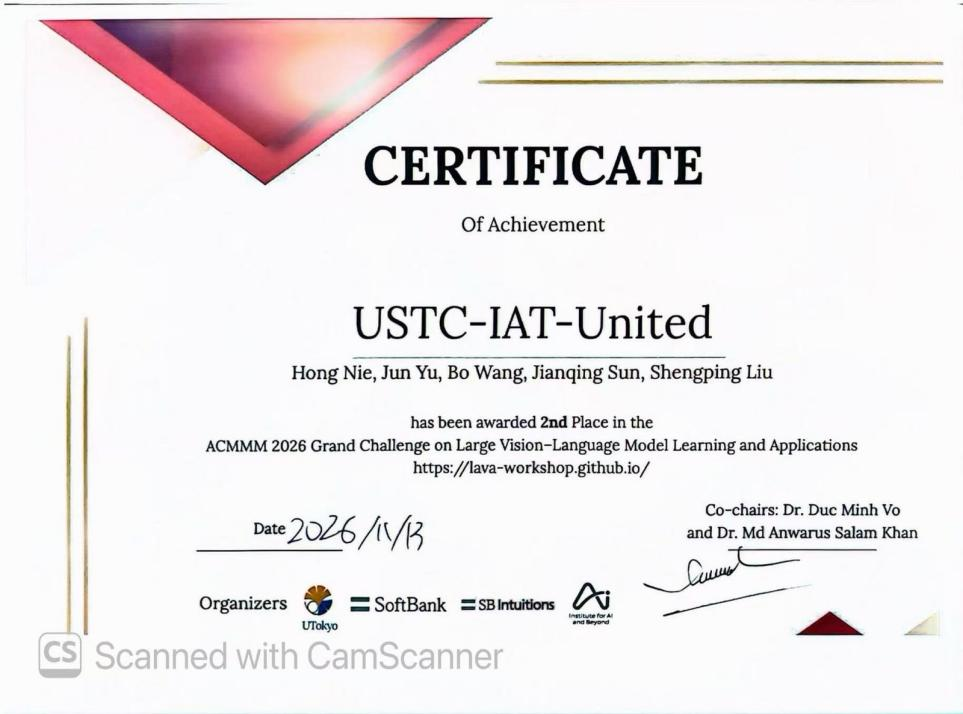
图8-LAVA 2026 挑战赛亚军证书(USTC-IAT-United 队)
图9-论文首页:Hierarchical Document Parsing(LAVA 2026 亚军方案)
ACM Multimedia是多媒体领域具有影响力的国际学术会议之一,被中国计算机学会列为CCF A类会议,长期关注多模态理解、视频分析、视觉—语言模型和人机交互等前沿方向。此次在系列挑战赛中取得的成绩,展现了云知声与中国科大研究人员在微动作分析、多语言文档理解等领域的研究与实践能力,也体现了双方在面向复杂真实场景开展技术探索方面的合作成果。
从细微动作的识别与检测,到跨语言、长文档的视觉理解,相关研究聚焦多模态智能中的实际问题。未来,云知声将持续探索多模态技术的发展与应用,推动研究成果在更多场景中发挥价值。