两千多年前,李斯在《谏逐客书》里写道:"河海不择细流,故能就其深。"河海之所以深,不是因为它只收大江大河,而是因为它不拒细流,每一条都容得下。
卓驭是一家聚焦移动物理 AI 的科技公司,为乘用车和商用车提供辅助驾驶解决方案,并把智能能力延伸到更多移动场景。它的数据来源繁多、形态各异:车载相机拍下的视频、激光雷达扫出的点云、语音与文本,连同企业日常运转产生的经营数据,源出千川,终归一湖。移动物理 AI 的底座要有这样的容量,无论多杂的数据都放得下、管得住。真正难的不是把数据收进来,而是收进来之后,怎么让它们在多年累积、持续增长的过程里,始终保持可查、可用、可复用。
01 卓驭:移动物理 AI,智能一切移动
这样的底座要求,来自卓驭的技术路线。它的原生多模态基础模型,在预训练阶段就把文本、语音、动作等不同模态放在一起联合训练,在统一的表征空间里完成对齐。与"先语义理解、再物理推理"的分阶段路线相比,这种模型形态的能力上限更高,对底座的要求也更苛刻:不同模态的数据,必须以统一的方式组织和处理。
算法的演进一直在加码。几年之间,智驾算法从模块化感知走到 BEV、端到端、VLA,再到原生多模态基础模型。收益的另一面是代价:每一代算法对算力和数据的需求,大约是上一代的 5~10 倍。

算法每演进一代,都需要身后的数据湖更深、更宽。
02 行业的四大难题
弹性、成本、稳定性、性能,四个目标相互牵制:当系统逼近帕累托前沿(想改善任何一项指标,就必须牺牲其他指标的临界值)卓驭把当下的难题归成四类:
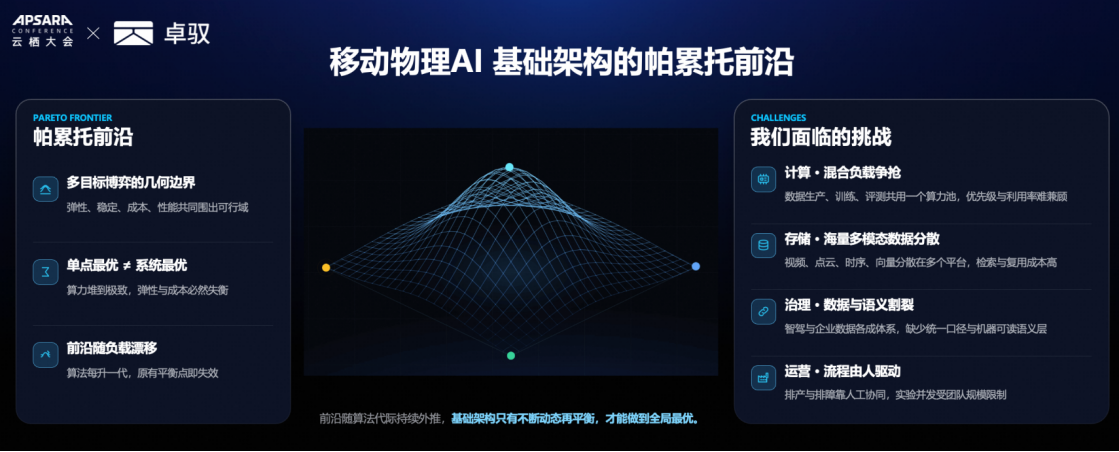
• 计算:训练、数据生产和评测任务共享同一资源池,调度既要响应业务优先级,又要抬高整体利用率。
• 存储:海量多模态数据分散在不同平台,跨平台统一检索与复用始终有难度。
• 治理:企业运营数据与智驾数据分属两套体系,缺少机器可读的统一语义层。
• 运营:不少流程仍靠人工推动,训练效率和数据生产能力被团队规模锁住上限。
面对持续增长的数据和算力需求,卓驭选择借助云上的弹性与托管能力,对原有湖仓链路做系统性重构。
03 把湖仓搬上云
阿里云大数据 AI 平台为移动物理 AI 提供了一条端到端的数据链路:规模化加工、湖上存储治理、统一检索供给、训练评测闭环,环环相扣。卓驭依托 DLF(数据湖构建)+ EMR Serverless Spark + EMR Serverless StarRocks + PAI,把原本分散在多个自建平台的链路,重构成一座跑在云上的多模态湖仓——这就是 ZLake 的底座。
Spark 负责规模化加工,DLF 负责湖上存储与元数据,StarRocks 负责统一检索与高质量供给,PAI 负责训练、评测与推理;卓驭自研的 Meta Lake 叠加其上,沉淀资产化管理能力。弹性、成本、稳定性、性能四个相互牵制的目标,被纳入同一套架构统筹求解。
04 一段数据的湖仓之旅:加工、入湖、检索、回流
车端采集与回传只是起点。一段车载视频要变成模型能直接加载的训练数据,还要在云上依次经过四个环节:加工、入湖、检索、回流。
• 加工:规模化处理。EMR Serverless Spark 做粗洗——格式归一、去重、切片,在弹性资源上按需伸缩;基于 GPU 的 AI 函数在同一个引擎里完成 OCR、分割编码、深度估计与 Embedding 抽取,Ray 集群承接 SLAM、4D 重建、真值计算等更重的精加工。粗洗与精洗在同一条产线上流转。
• 入湖:多模态统一存储。DLF 提供统一的技术元数据、权限与存储管理,通过 Lance、Iceberg 等开放表格式,让文本、图像、音频、视频、点云和向量在同一座湖里被多个引擎共享读写。卓驭自研的 Meta Lake 在其上承担业务资产目录、血缘追踪和合规治理:无论什么形态,都用表来管理、寻址、检索,不为不同形态重复建设链路。
• 检索:数据找得到、供得出。EMR Serverless StarRocks 承担湖仓多模态统一检索,支撑标签筛选、数据集与版本管理、质量校验和训练直供加速。困难样本挖掘能体现这种统一的价值:一次筛选可能同时用到向量检索、关键词匹配、标量过滤和地理圈选,这些条件组合在同一条基于表的查询链路中。
• 回流:数据与模型互为输入。PAI 在同一平台上串联训练、评测与推理;评测结果回流入湖,数据与模型互为输入的闭环就此合拢。
贯穿全程的,是"一湖两域":一域承载企业运营数据,一域承载物理世界的智能数据,两类数据汇入同一个湖,也共享一套认知模型——Ontology,对两个领域的对象、关系和规则做统一表达,让不同来源的数据拥有机器可读、可理解的语义;建模即治理,使用即治理。
语义打通后,两个领域开始互相支撑。车端一次异常事件,沿着事件与车辆、生产批次、物料的关联,能追溯到潜在的质量问题;路测中测试员某段比当前模型更稳健的驾驶操作,被筛成高质量样本,供给下一轮迭代。
05 下一步:让基础设施自己运转
卓驭的基础架构走过两个阶段:先是平台建设,底层演进为云原生架构;然后是数据闭环,把平台串成产线。两个阶段的共同点:关键环节仍要人驱动。2026 年以来,卓驭开始探索第三阶段 AI² Infra:基础设施不仅服务于 AI,运行流程也将逐步由 AI 参与驱动。
场景一,自主化生产运营。卓驭借用自动驾驶 L1 到 L4 的分级来描述目标状态:智能体承担大部分流程编排与运行调整,人负责设定目标与边界条件。上层的人定义数据需求和准出标准,中间层的业务智能体跟踪进度、调整优先级,底层组件把需求翻译成排产与执行队列。两层智能体共享同一套上下文,在产量、效率、质量与资源利用率之间持续调整。
场景二,AI 自迭代探索。智能体持续跟踪模型设计新进展,归类失败案例、识别模型表现不足的场景,提出改进假设;再从湖仓筛选数据、组织训练集、编排实验,完成后分析归因,有效的方案进入下一轮验证。人只做两件事——设定目标,把控模型发布与准出标准。
06 湖成之后
从一段车载视频入湖,到一次评测结果回流,这座湖仓每天都在重复同一件事:把物理世界里稍纵即逝的瞬间,变成模型可以反复学习的经验。经验越积越厚,湖就越蓄越深。
也许某个清晨,一辆测试车驶过一段湿滑的乡道,车轮碾过积水,摄像头记下了那一刻。当天夜里,这段视频已经入湖、切片、打上标签;几天后,它出现在新一版模型的训练集里。
这就是卓驭与阿里云一起做的事。卓驭懂车、懂物理世界,也懂模型需要什么样的数据;阿里云把计算、存储、湖仓与训练平台铺成河床。河床不生产水,却决定水能流多远。等下一代算法到来,卓驭不必从零再挖一座湖,活水会沿着已经铺好的河道,自己流进来。