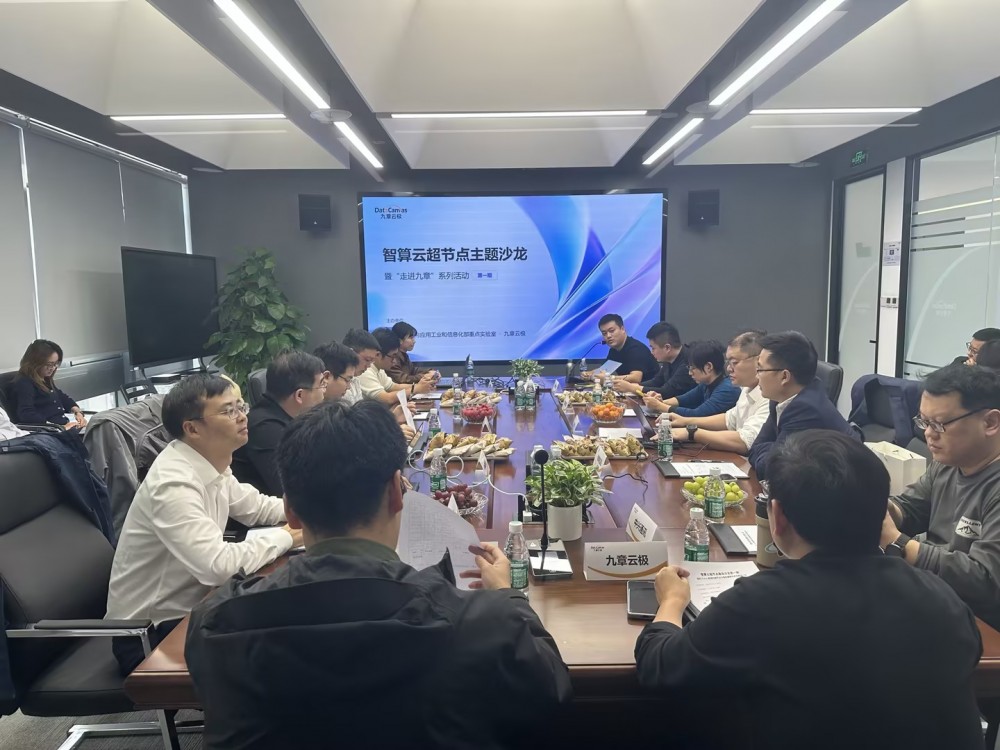
近日,由云计算标准与应用工业和信息化部重点实验室(以下简称“云计算部重点实验室”)与北京九章云极科技股份有限公司(以下简称“九章云极”)联合主办的“面向Token推理的超节点与超级集群技术专题研讨会”在北京举办。来自AI芯片、服务器整机、网络设备等产业链各环节的十余位技术专家及代表参加,围绕超节点架构创新、集群网络性能优化、大模型推理加速与Token成本优化,通过专题分享与开放研讨展开交流。
从硬件性能到系统效率,超节点成为推理时代的关键命题
随着大模型向长上下文、复杂推理及Agent应用持续演进,人工智能基础设施正面临更为复杂的计算与通信需求。与会专家认为,产业关注的重点正在从单一硬件性能与算力规模扩张,转向系统级计算效率与Token服务产出能力的提升。
超节点通过高带宽、低时延互联将多个计算单元组织为紧密协同的系统,为大规模模型训练与高效推理提供了新的基础设施形态。但计算单元数量的增长并不必然带来系统性能的同比例提升,通信瓶颈、资源利用效率和系统建设与运行成本,都需要硬件、整机、网络、系统软件与云服务等产业链各环节共同破解。
云计算部重点实验室代表表示,超节点的热度来自需求,但决定它能走多远的,不是单个系统规模有多大,而是这套系统能不能被稳定、经济地长期运营下去。“产业界在系统架构、互联方式和资源调度上已经有了很多不同实践,技术路线多样化本身不是问题,评价方法的缺位才是。不同方案没法放在同一套口径下比较,用户就很难判断该为哪一种付费。”他表示,举办这类技术沙龙,目的是把一线工程实践中真正卡住的问题收集上来,再往专题研究、联合测试验证和标准化预研上推进。
当天下午的四场专题分享覆盖超节点产业链的不同环节,分别从系统架构设计、大规模互联下的网络性能优化、面向Agent应用的算力底座以及高通量推理基础设施等方向展开。
衡量口径正在变化,评价方法仍缺共识
随后的开放研讨中,讨论沿着从评价方法到工程细节的路径展开。Token的成本构成目前仍缺少统一界定,影响因素横跨硬件架构、推理框架、缓存管理与资源配置多个层面,一批已有的优化路径在工程实践中的落地程度也不一。训练和推理用的超节点是否需要分型,是另一个尚未收敛的分歧,两种选择在技术实现路径与成本结构上各有权衡。落到具体负载,TP、EP并行通信与PD分离场景下的KV Cache传输特征各异,网络拓扑、通信路径与流量调度都需要针对性设计。
随着智算基础设施向规模化推理服务演进,算力系统的衡量口径本身正在变化。理论计算性能与硬件规模已不足以完整反映一套系统的价值,实际Token吞吐、响应时延、资源利用率、系统可靠性与全生命周期成本正在成为并列的评价维度。而这套多维度的评价方法,目前还没有形成行业共识。
九章云极副总裁胡宗星在会上指出,讨论算力的方式本身正在变化。“过去我们习惯从硬件这一端往上看:性能多高、规模多大、价格多少。但当客户的采购单位从机时变成Token,这套问法就不成立了。客户真正要算的是,业务跑完一个周期,摊到每个Token上花多少钱,以及这个数字能不能持续往下走。”
他表示,算力要成为可以计量、可以交易的通用生产力,前提是行业先有一把共同的尺子。“这把尺子不可能由任何一家企业单独定义,但必须先有人开始用、开始算,才有机会慢慢变成共识。”
九章云极将312 TFLOPS的FP16理论峰值算力运行一小时定义为1 DCU(一度算力),作为统一的算力折算基准。该基准用于跨硬件平台的资源计量,不代表具体硬件的实际性能。
在这一计量体系下,硬件价格的比较被转换为单位Token交付成本的比较,为资源分配、服务计量与经营分析提供了统一依据。
未来,云计算部重点实验室将继续联合九章云极及产业生态伙伴,围绕超节点与超级集群、异构算力协同、大模型推理基础设施优化等方向组织不同主题的技术沙龙,探索从技术交流、专题研究到联合测试验证及标准化预研的协同路径。不同架构下的计算与网络效率评价、异构算力资源管理、智算云服务能力与Token计量计费等课题,也将结合真实工程实践持续推进。