让一个新模型运行起来,只是AI工程链条的第一步。真正的难点,是在不同于实验室的实际运行环境中复现已验证的性能,再接入服务栈、建立稳定基线,逐层定位模型、运行时、软件与硬件之间的瓶颈。
九章智算云近期用三组工程实践回答了这道题:GLM-5.3单并发解码速度提升至原生方案的3.41倍;DeepSeek V4 Flash训推计算差异降至零;DART-GUI-7B 在 OSWorld 7B 赛道拿到第一。三组结果,覆盖推理优化、训推一致和模型后训练三类关键环节。
三组实践能够在同一平台上跑通,并将适配与优化经验沉淀为一键复现能力。这类把多个模型的适配经验集中到一个入口上交付的做法,目前在国内智算云里还不多见。这套能力也开始向 Agent、具身智能等场景延伸。
当算力、推理、数据、调度和训练引擎分散在不同环节,如何将它们组织成可持续运行、可规模化交付的工作流,是AI新云从算力供给走向工程交付的关键。九章智算云从模型适配到Token生成的全链路实践,将分散的基础设施环节整合为支撑AI业务运行与迭代的系统能力。
一个入口,三类工程问题
九章智算云这次展示的不是单一模型的单点优化,而是覆盖推理优化、强化学习训推一致和模型后训练的多组工程实践。不同模型遇到的瓶颈不同,对底层基础设施的要求也不同。
GLM-5.3验证了推理侧的加速。九章智算云披露的Alaya-DFlash2实践:在GLM-5.3模型、8张H200、TP=8配置下,32k低熵上下文,单并发解码速度达288.2 Token/s,约为原生自回归解码的3.41倍;64并发下总吞吐达到608.71 Token/s,较原生方案提升44.9%。
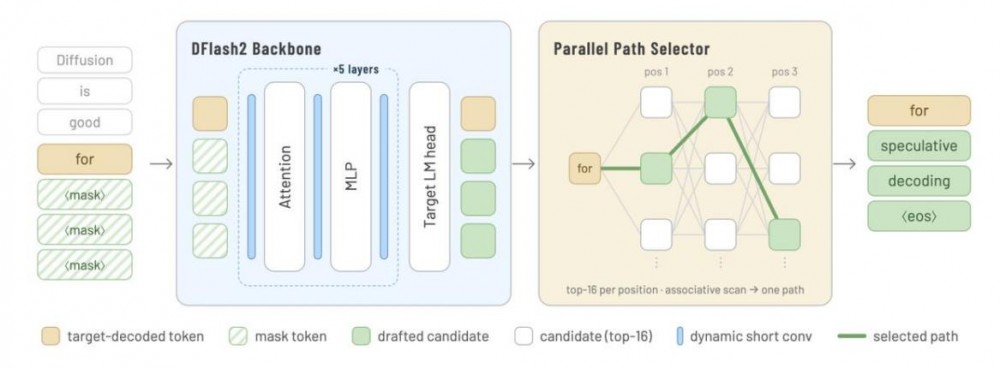
(图1:Alaya-DFlash2通过动态路径选择生成推测解码草稿Token)
推测解码由草稿模型生成候选Token,再由目标模型并行验证,以减少逐Token生成等待。Alaya-DFlash2进一步将其优化为可一键复用的推理方案。
复现DeepSeek V4 Flash解决的是AI基础设施中更隐蔽的计算一致性问题。强化学习要求模型生成端与训练端不仅能够高效协作,还要尽可能保持计算逻辑一致。通过让两端复用一致的计算内核和算子实现,减少不同计算路径带来的数值偏差,九章智算云将训推一致性落实到具体工程环节。
DART-GUI-7B 讲的是后训练这一段。这是一个 7B 规模的 GUI 智能体,在九章智算云的强化学习平台上完成训练,在 OSWorld 7B 赛道拿到第一。OSWorld 模拟真实操作系统环境,要求模型操控浏览器、表格、邮件客户端这些桌面应用完成任务,限时 30 步、零容错,对 7B 模型长期属于做不了的事情,基础成功率不足四分之一。在这一限制下,DART-GUI-7B 在图像设计类任务上的正确率达到 80.77%,在文档查找、页面导航这类真实任务上的成功率超过 90%。
三类场景汇集到同一个九章智算云平台入口。对模型企业而言,这意味着在相同硬件下承接更多请求、降低单位Token成本;对研发团队而言,则意味着减少重复的环境适配、性能调优和排障工作,把精力放回模型本身。
训推一致:DeepSeek V4 Flash的答案
算力加速卡之外,强化学习把工程问题带到了更深处:负责生成Token的推理系统,与负责更新模型的训练系统,是否使用一致的计算逻辑?
强化学习通过生成端产出轨迹、环境端提供反馈、训练端依据奖励更新参数,形成持续迭代的闭环。为提高效率,三者通常异步运行,但若训练端与生成端采用不同的算子实现或数值精度,即使模型权重相同,也可能产生概率偏差,导致训练依据的策略与实际执行不一致,影响后续更新的稳定性。
这在具身智能中也有直观体现:机器人根据摄像头画面判断杯子位置并生成抓取指令,系统再根据实际执行结果计算奖励、更新模型。如果训练与推理的计算结果出现偏差,训练依据的策略就可能与实际执行脱节。
针对这个问题,九章智算云用DeepSeek V4 Flash的强化学习实践作答。在32张算力加速卡的GRPO训练中,基线配置下训练端与生成端的概率偏离度从0.002升至29.9,并伴随奖励回退;通过复用推理侧计算内核、逐算子对齐计算路径,团队把特定测试条件下的计算差异降至0,同时保留性能基线91.3%的生成吞吐。
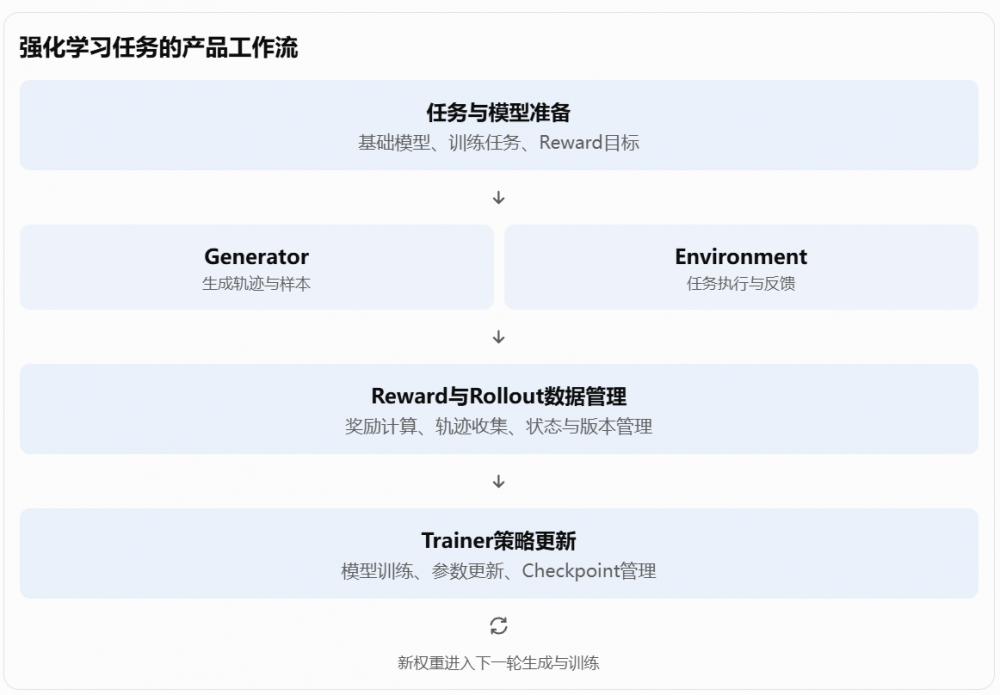
(图2 九章智算云Agentic RL强化学习工作流)
训推一致,并不是简单追求数值完全相同,而是在控制性能开销的同时,让训练与推理尽可能采用一致的计算路径。
训推一致与训推协同是两个相互关联、但并不相同的工程命题:前者关注两端计算结果是否一致,后者关注系统如何高效组织训练与推理任务。两者共同决定AI基础设施系统能否兼顾训练效率与策略稳定性,对具身智能、Agent这类高度依赖实时反馈的任务尤为关键。
从Agent到具身智能,训推工程进入应用场景
模型复现和性能优化只是工程能力的起点。当模型进入真实任务环境,工程问题也从模型运行和计算一致性,延伸到如何组织模型生成、环境反馈和训练更新。数字Agent和具身智能,分别呈现了这一闭环在虚拟与物理环境中的不同要求。
在物理环境中,具身智能的闭环更复杂。服务机器人需要通过摄像头和传感器感知环境、生成动作,再根据执行结果调整行为。研发过程还涉及视频数据处理、仿真与真实场景迁移,以及云端训练和边缘推理。
与九章智算云合作的一家世界模型研发企业,围绕模型训练和应用验证,通过九章弹性容器VKS将训练资源从8卡扩展至256卡,按需使用模式较裸金属租用方案降低82.1%的成本,并支持模型缓存、具身数据处理、视频IO及云端训练与边缘推理的衔接。
从Agent到服务机器人,任务环境不同,对基础设施的要求也从模型推理和训练反馈,延伸到视频数据、真实环境验证与边缘部署。这些实践说明,AI工程平台不仅要保证模型能够训练和运行,还要支撑模型在持续交互中迭代,并适应不同应用场景的交付要求。
从工程能力到产品,沉淀为平台资产
支撑模型复现和应用场景的,是九章智算云覆盖训推全链路的工程体系。从计算资源的弹性调度,到训练数据、模型权重和运行状态的管理,再到推理服务优化与强化学习异步执行,各项能力围绕模型运行和迭代形成协同。弹性容器与异构资源池负责组织算力加速卡资源,存储和高速数据传输支撑数据与状态流转,Alaya-DFlash2等方案优化Token生成效率,强化学习系统则承担模型更新、奖励计算与版本管理。
这些技术不是彼此独立的组件,而是围绕具体任务协同运行,才能把算力加速卡资源转化为训练效率、推理吞吐和实际任务表现。据披露,九章智算云强化学习系统算力加速卡使用率稳定在99%以上,端到端训练效率较行业平均提升500%,综合成本下降60%。
更长期的价值,在于工程能力能在交付中不断沉淀。每一次模型适配、性能调优和任务部署,都有机会形成可复用的配置、组件与工作流;这些经验进入下一次交付,可缩短新模型、新任务的适配周期,降低重复工程成本。四大模型的一键复现,正是这种能力从一次性人工调试走向平台化流程的体现。
随着大模型进入持续迭代阶段,训练与推理通过数据生成、环境反馈和参数更新形成循环,资源调度、数据管理、计算一致性与推理性能也成为相互关联的工程问题。AI新云的竞争因此不再局限于算力加速卡规模和资源价格,还取决于模型适配、端到端性能、训推工作流以及稳定交付能力。
从公开披露的客户结构看,训推一体已经是九章智算云的主要负载之一。这类任务对计算一致性和端到端吞吐的要求最高,前面那几组工程实践基本都落在这个方向上。这一能力并非单纯依靠算力加速卡规模,而是建立在覆盖资源调度、数据流转、推理服务和训练任务的完整技术栈之上。下一步,九章需要证明的是,如何将这套技术能力沉淀为成熟的商业产品,并推广到更多模型、任务和企业场景中,实现稳定、可规模化的交付。