随着对话式 AI 进入客服、教育、陪伴和智能硬件,用户会越来越频繁地用日常说话的方式提出需求。这也给企业在选择语音通话技术时带来新的问题:服务商能否帮助产品处理真实环境中的声音、网络和对话节奏?
10 月 23 日,在北京举行的 iRTE2026 实时智能大会上,声网创始人兼 CEO 赵斌提出“五级对话能力”框架,讨论 AI 从基础应答走向深入沟通的演进方向。随着实时互动从人与人扩展到人与 Agent,声音传输、连续交流和任务执行之间的配合,也成为产品落地需要解决的问题。
对于准备接入对话式 AI 的团队,可以从以下四步入手,把流畅通话落实到具体体验。
第一步:处理好环境噪声,让 AI 听清用户
噪声处理不是“降噪越强越好”,而是关键信息不能被漏掉。
用户说“明天下午三点”,如果“三点”被环境声盖住,后续回答就可能偏离需求。
评估语音通话服务商,首先要看它怎样处理真实声场:能否抑制环境噪声,减少设备回放形成的回声,并尽量保留用户表达中的有效信息。
在噪声处理这个维度上,声网语音通话提供 AI 降噪、AI 回声消除等能力,支持一对一和多人语音互动。团队可以根据客服、陪伴、教育等场景配置音频能力,再使用实际设备测试远近距离、免提通话和多人声干扰下的表现。
第二步:减少整条链路的等待,让回答及时抵达
用户感知的是从提问到回答整个过程的等待,不是单个环节的延迟。
用户说完一句话后,声音需要经过采集、处理和传输,再进入模型理解、回复生成与终端播放,每个环节都可能产生等待。如果等待时间过长,用户可能重复提问;系统此时开始回答,又容易与新的表达重叠。
因此,实时语音方案的评估,需要同时覆盖网络传输和 AI 服务的衔接。基础通话延迟、模型处理耗时与完整对话响应时间,应分别观察,才能找到真正需要优化的环节。
在接入方式上,自行组合语音识别(ASR)、大语言模型(LLM)和语音合成(TTS),与采用集成编排能力的对话式 AI 引擎,可以从模型适配、轮次管理、异常处理和后续维护成本几个维度比较。团队需要确认哪些工作由平台提供、哪些仍需自行开发,以及更换模型或语音服务时需要调整多少业务代码。
声网对话式 AI 引擎支持编排语音识别、大语言模型和语音合成等服务。团队可以围绕完整流程选择、接入和调试相关能力,让声音输入、模型响应与语音播放更连贯地配合。
第三步:识别停顿与插话,让用户随时补充需求
打断处理的关键问题不是“能不能打断”,而是打断后新一轮能否继续流畅互动。
“帮我查明天上午的航班……不对,是下午。”
对于这样的日常对话,系统如果过早开始回答,可能遗漏后半句;如果一直等待,又会让用户不确定是否需要继续说话。
这让轮次判断和打断处理成为对话式 AI 的重要能力。用户短暂停顿时,系统是否留出补充空间?AI 回答过程中,用户能否及时纠正条件?打断之后,新一轮对话能否顺畅开始?这些都需要单独验证。
在打断与轮次判断这个维度上,声网对话式 AI 引擎支持语音打断和手动打断,并提供可选的基于语义判断发言是否结束的能力。技术文档同时说明,等待用户补充表达可能增加响应延时,团队需要结合任务配置交互策略。
第四步:在真实网络中验证,并持续跟踪通话质量
演示环境通过不等于真实网络通过,语音通话质量要能定位到环节。
办公室里的一次演示,很难覆盖用户的全部使用环境。对于面向多地区用户的语音产品,团队还需要观察不同网络与终端组合下的表现:通话是否出现断续,回答是否明显变慢,异常是否集中在某类设备或特定区域。将问题定位到具体环节,后续优化才有明确方向。
在质量可观测性这个维度上,声网水晶球 Analytics 提供通话质量监测、回溯与分析能力,支持具体通话调查、质量趋势观察、实时监控和告警。结合模型与业务侧记录,团队可以进一步分析等待、断续等问题发生在哪个环节。
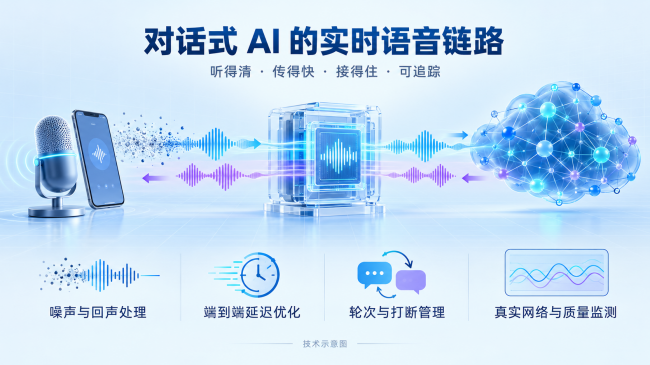
综合上述四个步骤,对话式 AI 的流畅通话,需要噪声与回声处理、端到端延迟优化、轮次与打断管理,以及真实网络下的持续验证共同支撑。声网语音通话与对话式 AI 引擎提供可组合的实时交互能力,水晶球 Analytics 则支持上线后的通话质量监测、回溯与问题定位,帮助团队持续优化用户体验。
#声网 #语音通话 #对话式AI #实时语音