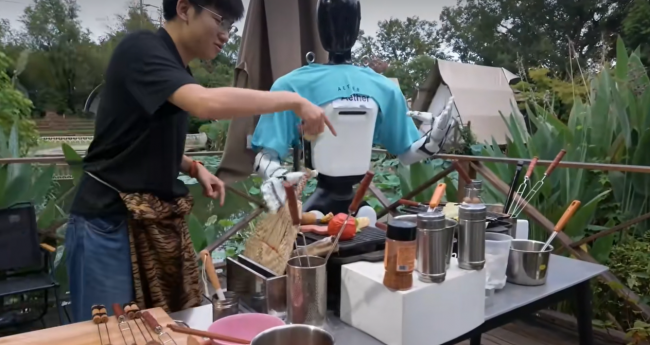
9月16日,乐享科技在上海完成全球首次具身智能大模型长时户外全自主直播:搭载其全新以太大模型的机器人在真实户外环境中连续作业1小时,从点单、任务规划、烧烤到上菜,全程自主完成。这也是全球首次,多台机器人在真实开放环境中自主交互、协作完成一整套任务。
直播结束两天后,乐享科技于9月18日进一步发布以太大模型真实场景应用的第二个"一镜到底"视频。
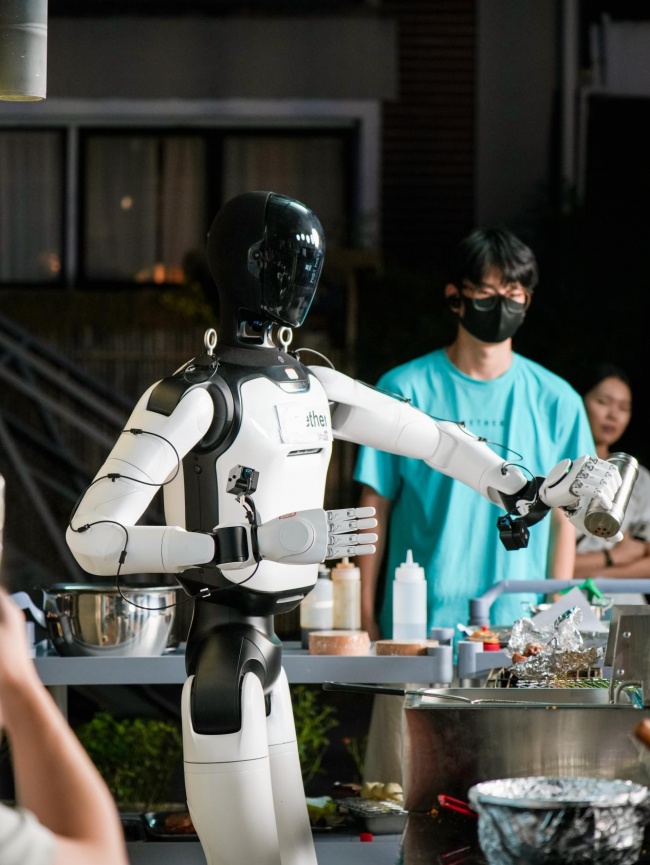
本次直播在线上超550万观众及现场超30位行业媒体的见证下进行。现场6名顾客随机点单、更改及新增需求,并可随意挪动物品、打断任务。直播中还出现插曲:原定的一位顾客临时未能到场,乐享科技没有停播,也没有调整流程,而是从围观观众中随机邀请了一位补位,将"0预设、0剧本"贯彻到底。全程没有遥操,也没有剪辑掉"失误"片段的机会。
直播中,机器人展现出多项此前未有模型公开展示的能力:
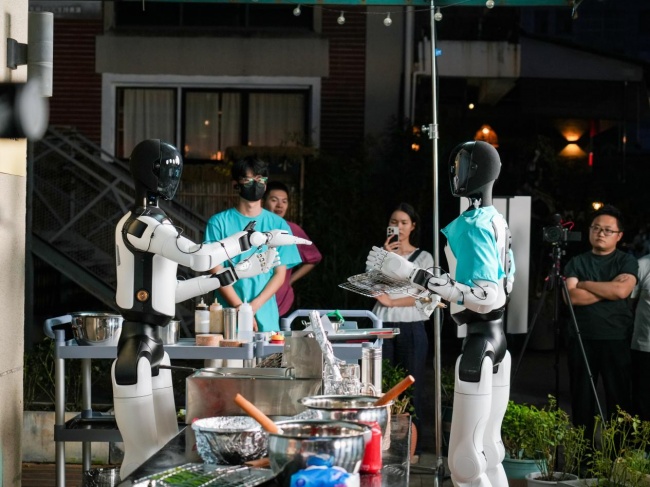
双机自主协作。烧烤机器人守在炉前,服务机器人穿梭于烤炉与餐桌之间,两台机器人互相传递任务信息,共同判断任务进度与配合方式。
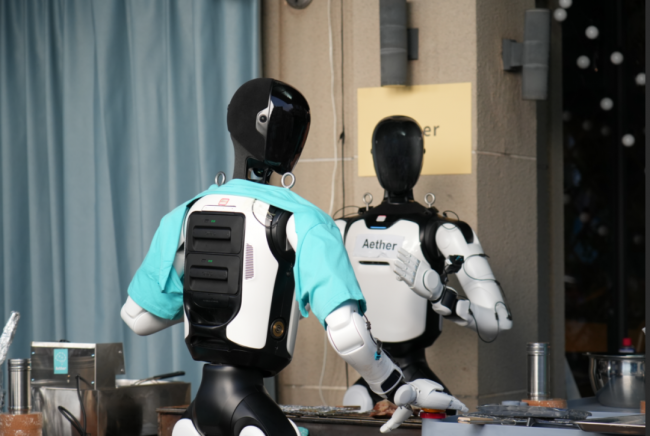
直播中两台机器人被观众称为"二爷"和"五弟":服务机器人会将顾客的个性化需求(如多加辣椒粉)告知烧烤机器人;感觉顾客等久了,也会主动追问出餐进度。据介绍,这一双机交互全程没有一个预设的触发条件。
长程任务断点续做。点单中途有顾客临时要求取水,机器人先将水送达,再回到桌边继续未完成的点单。期间它还主动为顾客递上纸巾——没有人提出过这一需求,完全来自机器人对场景规则的自主理解。
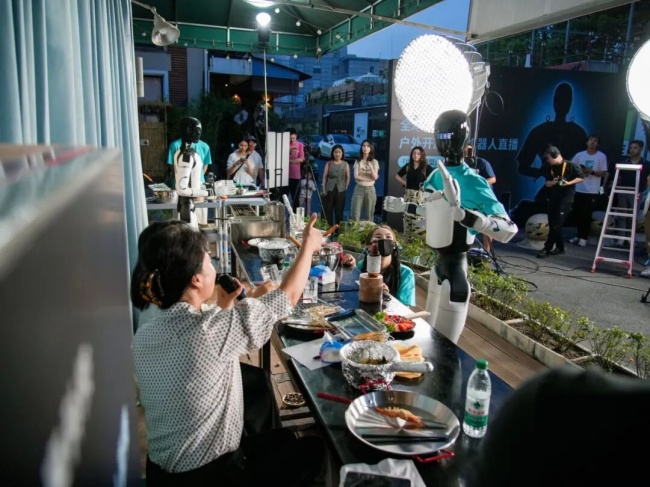
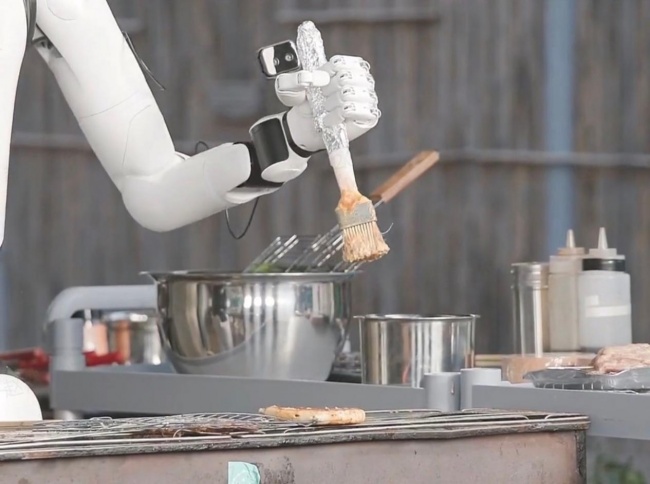
精细操作与现场自学习。烧烤机器人按顾客要求将调料精准撒到食物上,并在恰当的时间主动刷上酱汁。它第一次抓调料瓶时未拿稳,经数次尝试后动作明显变稳——每一次抓取的成败,都直接成为修正下一次动作的依据。
开放环境全身协调控制。直播场地完全开放,桌椅位置与人员动线事先无法预设。机器人迈出的每一步都是现场看、现场判断、现场决定,不依赖提前建好的地图和写死的路线。
支撑此次直播的以太大模型,是乐享科技推出的全球首个跨本体通用具身大模型,具备主动感知、多模态理解、流式记忆、动力学建模、持续自我迭代五项相互咬合的核心能力,并实现了三个"全球第一":
全球第一个能量驱动的通用智能模型。不直接预测动作,而是把目标完成度、动力学一致性、记忆一致性、物理约束等统一为连续的能量景观,沿能量梯度持续推理、主动探索、生成动作。
全球第一个类人脑神经元模型。把"大脑—脊髓"的贯通机制搬进机器,运动轨迹不靠数据"猜"、靠物理约束"学"。
全球第一个自进化的具身智能模型。Evolution Manager让自我模型与世界模型从参数级到模型级持续自进化,部署不是能力的天花板,而是成长的起点。
乐享科技表示,拿下"全球首次"不是这场直播最重要的意义。真正重要的是:一个具身智能模型,开始能离开高度受控的实验室,在不断变化的真实世界里持续工作。烧烤只是一次"真题"考试,未来不管机器人走进家庭、商业服务还是更多真实场景,它面对的始终是一个无法提前写完所有答案的世界。
9月18日,乐享科技发布的第二个"一镜到底"视频,在此前十分钟双机协作的基础上,进一步加入了外界对任务的频繁打断、更精细的操作任务,以及机器人对人的意图理解与人机交互。