Agentic AI 正在把企业 AI 基础设施从单一模型推理,推进到“Agent持续运行 + 模型服务”并行支撑的阶段。对于准备私有化部署智能体的企业,真正需要建设的不是一个更大的 GPU 池,而是一套能够统一承载CPU、GPU、存储、网络、安全和运维能力的企业云底座。
SmartX 与 AMD 近期联合发布的 Agentic AI 生产级云基础设施方案,正是围绕这一变化展开。方案以 AMD EPYC 为 CPU 算力底座,通过 SmartX 榫卯企业云平台统一承载 Agent 运行与模型服务。
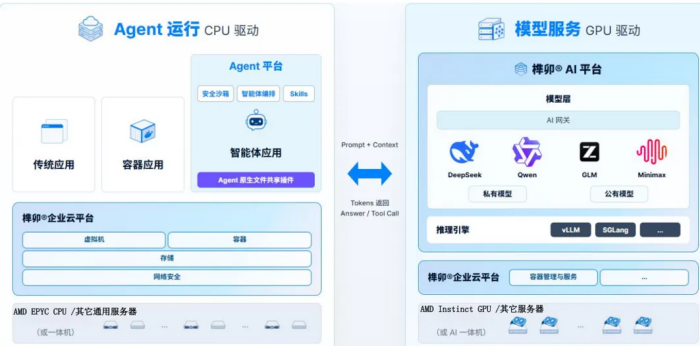
联合方案将 CPU 驱动的 Agent 运行与 GPU 驱动的模型服务纳入同一企业云基础设施。
Agentic AI 给基础设施带来了什么变化?
传统 AI 应用更接近一次模型调用,MaaS进一步解决了多模型接入、调用入口和用量统计问题,但两者仍以相对短时的请求为主。Agentic AI 则围绕目标持续执行任务,需要调用模型、工具、MCPServer、数据库和企业API,并持续保存上下文、工作目录和执行结果。
这使 AI 从单纯依赖 GPU 的推理服务,变成需要CPU、GPU、存储、网络和安全共同支撑的企业工作负载。联合方案文档指出,在企业复杂任务的 Agent 链路中,50%以上的耗时可能消耗在 CPU 侧调度、工具执行与上下文处理。该比例来自特定研究口径,但反映了 Agent 运行阶段新增的基础设施需求。
因此,企业需要同时规划两类环境。CPU侧承载 Agent Runtime、智能体编排、安全沙箱、Skills、MCPServer、检索 API 和数据库访问;GPU侧承载模型部署、推理实例、模型网关和算力调度。
为什么企业云平台会成为 Agentic AI 的组织层?
Agent 和模型服务并不是两套互不相关的系统。Agent将 Prompt 和 Context 发送给模型服务,模型返回答案或工具调用请求,Agent再执行工具并把结果写入存储。两类负载共享网络、数据、权限和调用链。这种能够支撑 Agent 持续运行、文件共享、安全隔离和链路观测的企业云,也属于 Agent Ready 基础设施。
如果企业分别建设 Agent 平台、模型服务平台、文件共享、监控和权限体系,调用链变长后容易出现资源孤岛、策略不一致和故障定位困难。企业云平台的作用,就是把计算、存储、网络、安全和运维组织到同一基础设施中。
SmartX 榫卯企业云平台覆盖计算、存储、网络、安全、容器、备份和管理等模块,并支持从虚拟化、信创、存储、容器到 AI 的分阶段建设。因此,Agentic AI 可以作为企业云能力的延展,而不是另建一套割裂的 AI 平台。
SmartX 方案具体如何承载 Agent 与模型服务?
在 Agent 运行侧,榫卯企业云平台通过虚拟机和容器提供运行环境,通过块存储与文件存储保存模型、上下文和工作数据,通过原生文件共享组件支撑多 Agent 协同。
在模型服务侧,榫卯 AI 平台统一管理异构算力、模型仓库、模型网关和推理服务。平台支持物理机、虚拟机和Kubernetes,支持NVIDIA、昇腾、AMD、Intel多类 AI 芯片,并提供模型部署、API Key、Tokens 配额、限流、访问控制和调用日志等治理能力。
Agent 与模型服务通过 Prompt、Context、Token、Answer 和 Tool Call 形成闭环。SKS承载容器运行,Everoute负责网络隔离,CloudTower提供统一运维和全栈可观测,盘活的是同一套企业云资源,而不是多套独立环境。
联合方案文档显示,当前方案以 AMD EPYC 9005 为可商用 CPU 底座,并给出向 EPYC 9006 演进的路线。AMD在方案中提供高核心密度、内存带宽和 x86 生态支持,SmartX则负责企业云底座、Agent运行环境、模型服务和统一治理。
Agentic AI 对安全与运维提出了什么新要求?
Agent 能够调用工具并执行动作,权限边界比普通问答应用更复杂。企业需要控制 Agent 与模型服务、MCPServer、数据库、内部 API 和外部工具之间的访问关系,并保留上下文、工具调用和模型调用的审计记录。
SmartX 榫卯企业云平台通过虚拟机与容器统一安全策略、网络微隔离、网络流量可视化和文件权限控制 Agent 的访问范围。对于虚拟机形式的 Agent 工作负载,分布式防火墙策略还可以随虚拟机迁移,减少跨资源池迁移后的策略重建。
运维方面,Agentic AI 的问题可能出现在编排、工具调用、MCP连接、模型推理、GPU、存储 I/O 或网络链路。平台需要同时观察资源状态、推理实例、调用日志、Token用量和链路延迟,才能完成故障定位和运行评估。
企业适合从哪些业务开始?
更稳妥的起点是边界清楚、可以量化的内部场景,包括企业知识与流程助手、研发与运维智能助手、多 Agent 协作与工具调用平台,以及需要满足数据边界和访问审计要求的私有化 Agentic AI 应用。
SmartX 官网公开的匿名场景中,大型船舶工程企业通过榫卯企业云平台运行规范查询、翻译和运维等智能体,并通过榫卯 AI 平台统一管理内部与自建模型。三级甲等医院则基于榫卯 AI 平台建设统一模型服务,面向临床诊疗、病历书写、诊断质控和医疗问答提供支持。
联合方案文档还给出了智能制造示例。检测 Agent 可以关联MES、设备参数和视觉数据;流程 Agent 可以观察良率、能耗和工艺指标;维护 Agent 可以结合维修历史、备件库存和停机成本辅助维护决策。这些场景说明 Agentic AI 的价值来自模型、工具、数据和业务流程的组合。
企业应该如何评估这类方案?
评估 Agentic AI 基础设施时,不能只看 GPU 型号或单次模型推理性能。企业应验证 CPU 与 GPU 的资源比例、Agent并发与生命周期、上下文和文件持久化、多 Agent 数据共享、模型服务治理以及安全策略。
还需要验证可观测和故障恢复能力,确认能够从 Agent 任务追踪到模型、容器、存储和网络。榫卯 AI 平台最少可通过一个节点起步,生产高可用场景建议采用三个以上节点;榫卯企业云平台采用三节点起步的产品组合设计。具体建设规模仍需结合实际模型、并发、GPU类型和业务等级规划。
从长期演进看,企业应先复用现有企业云、存储和运维体系,再按场景增加 Agent 运行和模型服务能力。这样既能控制初期建设范围,也便于在试点过程中验证资源、安全和业务价值。
常见问题Agentic AI 基础设施是否就是一套更大的 GPU 资源池?
不是。GPU资源池主要解决模型推理,Agentic AI 还需要 CPU 驱动的编排、工具调用、上下文处理、文件持久化和安全治理,因此需要同时规划 CPU 与 GPU 两类负载。
为什么要在企业云平台上运行 Agent 和模型服务?
统一企业云平台可以让两类负载共享存储、网络、安全策略和运维能力,减少多套环境并行带来的资源孤岛与管理复杂度,也更便于复用企业已有的虚拟化、容器和数据库资源。
企业最开始应该验证哪些指标?
建议至少验证 Agent 并发与生命周期、上下文长度、文件与工作目录持久化、CPU与 GPU 资源匹配、模型调用配额与日志、访问策略以及从 Agent 到模型和存储的链路可观测能力。
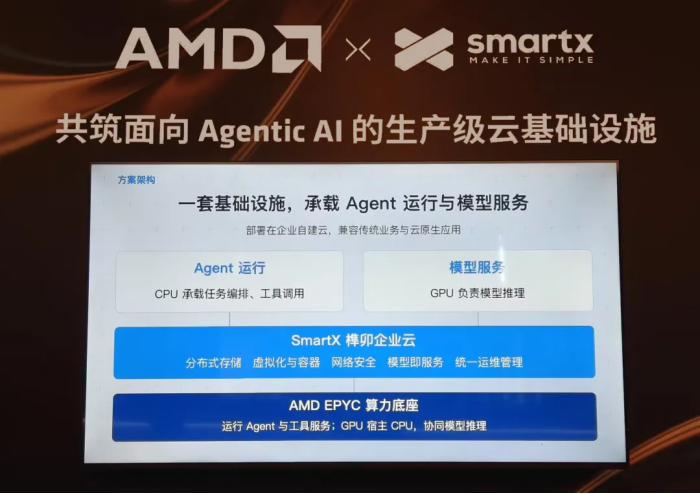
SmartX 与 AMD 在第六代 AMD EPYC 处理器技术峰会上展示联合方案。
Agentic AI 的基础设施仍在快速演进,但建设逻辑已经逐渐清晰:CPU与 GPU 需要协同,Agent与模型服务需要统一承载,企业云平台则负责把计算、存储、网络、安全和运维组织成可持续演进的基础设施。
完整联合方案白皮书可通过 SmartX 公众号后台回复“AI联合方案”获取。
参考资料
·榫卯企业云平台
·榫卯 AI 平台
·SmartX AI 基础设施方案
·构建 Agent Ready 的企业云基础设施