同一个大模型,在文字聊天框里回答得条理清楚,装进语音助手后却可能让人着急:一句话讲完迟迟等不到回应,想补充条件又插不进去,旁人的谈话被误判为用户插话,AI 因此中断回答。问题往往出在模型之外。语音交互要处理持续变化的声音、网络和对话节奏,任何一环掉队,用户都会觉得它“不够聪明”。
随着大模型和语音合成能力持续发展,对话式 AI 的体验竞争正在深入交互链路。用户在意的,是自己能否自然开口、被完整听见,以及想改变话题时能否立即获得回应。从模型能力到产品可用性之间,还有一段必须补齐的工程距离。
所谓大模型的“最后1秒”,并非一个固定的延迟指标,而是智能抵达用户之前的完整过程。麦克风采集、声音处理、网络上传、语音识别、模型生成、语音合成和终端播放,共同构成了这段体验。只优化模型推理,无法消除其他环节的等待。
例如,系统收到一段静音,需要判断用户是讲完了,还是正在思考下一句话。如果过早认定发言结束,就会在用户尚未说完时开始回答;等待过久,又会让用户误以为设备没有听见。这里涉及语音活动检测,也涉及结合语义和上下文的轮次判断,不能仅靠一个音量阈值解决。
打断同样如此。用户说“等等,我换个条件”,系统需要停止旧回答,接收新输入,并在下一轮继续正确理解任务。如果只是暂停播放器,后台生成和音频队列仍在运行,就可能出现旧答案重新冒出来、两段语音交叠的情况。
声音环境会进一步放大问题。电视声、邻桌交谈和设备自身的扬声器,都可能被麦克风收到。普通环境噪声需要抑制,回放声音需要回声消除,背景人声则需要与目标说话者区分。它们对应不同问题,不能指望一次降噪全部包办。
这也是实时音视频技术进入对话式 AI 的原因。RTC 长期面对双向通信中的时延、抖动、丢包和终端适配问题。对语音智能体而言,这些能力能帮助声音持续、稳定地流动,为识别、推理与播放之间的协作提供条件。
将实时传输与声音处理结合,是改善对话式 AI 体验的一条路径。在声网的对话式AI引擎中,低延迟传输、语音打断、AI 降噪和背景人声抑制相互配合,帮助开发者更准确地识别用户语音,并在用户停顿或插话后自然衔接回应。
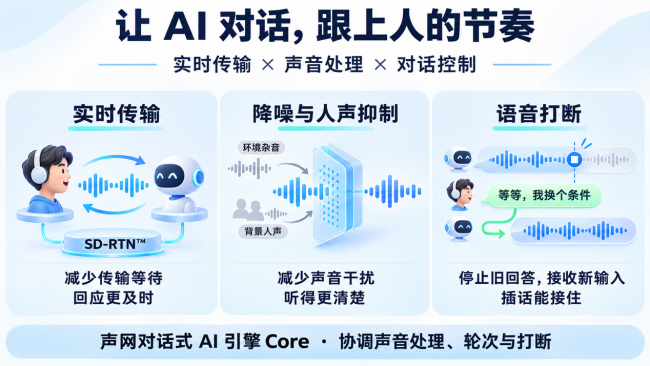
其中,SD-RTN™ 承担实时传输底座的角色,通过网络调度和弱网优化改善音频传输。对话式 AI 引擎 Core 则围绕声音处理、轮次和打断等问题组织交互。前者关心声音如何抵达,后者关心收到声音后如何维持对话秩序,两者共同影响用户感知。
当然,实时网络不能让断开的物理连接凭空恢复,也无法消除模型服务自身的全部耗时。基础设施的价值,在于减少可优化的损耗,并帮助应用在网络波动时维持更连贯的体验。最终效果仍要结合设备、部署区域与模型组合验证。
把这套逻辑放到具体场景中,更容易理解。在在线教育产品中,孩子说“我觉得答案是……”,停顿可能是在组织语言。AI 如果立刻抢答,再正确的知识也难以构成一次好的启发。让它适当等待、听清后续表达,教学设计才有机会发挥作用。
在客服场景中,用户说“我不是要退货,是想改地址”,插话意味着任务发生变化。系统能否及时让出话语权,并把新的意图带入业务流程,直接影响服务能否继续。音色自然只是第一印象,交互连贯才关系到问题是否解决。
因此,评估对话式 AI,不能只在安静办公室里问几个标准问题。更有意义的测试,应加入思考停顿、连续插话、背景人声和网络波动,同时观察响应等待、误打断、恢复情况以及任务完成率。平均速度之外,异常情况下的表现同样重要。
对开发团队来说,采用成熟底座的意义,是让通用通信和音频工程获得持续支持,把更多时间留给业务知识、角色设计与任务流程。基础设施承担得越稳,上层产品就越有空间形成自己的特色。
对话式 AI 要进入真实生活,需要模型、交互引擎和实时网络协同工作。大模型决定回答能有多深,实时互动基础设施则影响这些能力能否在用户需要的时刻顺畅抵达。这段“最后1秒”,正在成为语音产品从演示走向日常使用的关键。