第九届进博会中国馆,沐曦股份作为本届唯一入选的国产GPU企业亮相,带来了两款算力机柜:曦景S600超节点,以及与东方算芯联合推出的异构双擎算力机柜。国产GPU企业不少,为什么是沐曦进入中国馆?答案不在单卡跑分,而是沐曦的两款产品恰好实践了算力产业两个正在发生的趋势:同构横向做大,异构纵向做深,两条线并行推进。
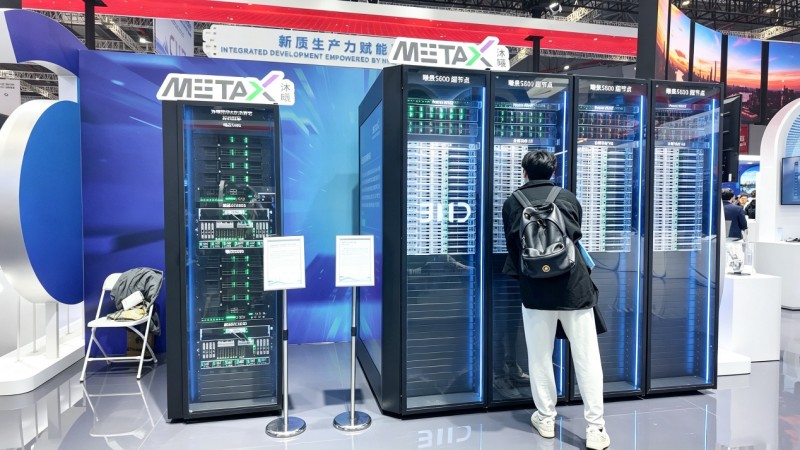
曦景S600超节点:把更多GPU连起来,也让整柜更容易部署
大模型任务分到多张GPU后,卡与卡之间需要频繁交换数据。互联跟不上,即使单卡性能很强,也可能花时间等数据。因此,超节点的价值不仅在于一柜能装多少卡,也在于这些卡能否高效协作。
曦景S600搭载曦云C600 GPU,配合沐曦自研的MXMACA软件栈与MetaXLink高速互联技术,单机柜支持128卡全交换,交换网络无带宽收敛;机柜之间可按业务需求横向扩展,支持组建万卡级集群。
机柜内部的布线同样是工程重点。S600采用高密正交整机柜和模块化设计,在计算节点内部、交换节点内部以及计算与交换节点之间,三处均采用免线缆设计。这套设计着眼于减少柜内布线和现场部署的工作量,让超节点更容易纳入智算中心的建设与运维流程。
异构双擎:同一次推理,两种芯片如何分工
云端推理的不同环节对硬件的要求并不相同:有的需要集中完成大量计算,有的更依赖从存储中快速读取数据。沐曦与东方算芯的异构双擎算力机柜,把曦云C600与东方算芯DF1000放进同一系统,按任务特点安排分工。
以混合专家模型为例,方案把注意力与专家网络拆到不同芯片上运行:C600主要处理上下文关联等计算密集型任务,DF1000主要承担稀疏激活等访存密集型任务。在投机解码场景中,分工更直观:DF1000先生成一组候选内容,C600再批量校验。两种用法都把计算和访存需求不同的环节交给更适合的芯片,目标是改善端到端推理效率。
从柜内高速互联到跨芯片任务分工,沐曦此次展出的两款机柜,展示了系统设计如何影响算力的使用效率:一端让更多GPU协同工作,另一端让不同芯片按负载协作。随着大模型走向更大规模和更广泛的应用,卡与卡之间怎样交换数据、不同芯片怎样分工、整柜怎样部署,都是衡量算力系统能否用好的具体问题。
不做选择题,两条腿走路
训练要“总量”,同构把一张卡的能力放大成机柜、成集群;推理要“结构”,异构把不同特性的芯片摆到各自最擅长的工序上。一端是Scale-up的系统工程,一端是跨架构的任务分工,合起来才覆盖从训练到推理、从通用到专用的完整场景。国产算力常在这两端“二选一”,代价是要么推理成本下不来,要么训练规模上不去。
沐曦股份以高性能通用GPU、系统级算力与异构融合能力为底座,坚持两条腿走路,赋能千行百业,展现了行业领军企业的战略眼光与落地实力。