在大模型智能体(Agent)加速走向产业落地的2026年,"记忆"正成为决定智能体能否持续进化的核心能力。
创邻科技携手香港科技大学(广州)联合发表的论文《EvoMemBench: Benchmarking Agent Memory from a Self-Evolving Perspective》,被全球人工智能领域最具影响力的顶级会议之一NeurIPS 2026数据集与基准赛道(Datasets & Benchmarks Track)正式接收。该研究构建了统一开源评测基准EvoMemBench。它沿"记忆范围"与"记忆内容"两大维度,首次将四类记忆演化场景统一纳入同一评测框架,并在统一协议下对15种代表性记忆方法与3个主流长上下文大模型进行了全面对比。研究系统揭示了记忆何时有效、何时失效、何种记忆形式适配何种任务,为智能体记忆系统的研发与选型建立了"统一度量衡"。
*点击页面底部"阅读原文",详细了解论文内容。
智能体落地的隐形瓶颈:记忆能力"难评、难比、难选"
随着大模型智能体从"对话助手"走向"业务执行者",企业对智能体的期待早已不止于单次问答。它需要在长时间的多轮交互中记住用户偏好与关键事实,在连续的工具调用中追踪任务进度,还要能从过往任务中沉淀经验,越用越聪明。
然而,大模型本质上是"无状态"的。它只能依据当前输入作答,并不会天然地保存和更新跨交互的信息。把历史记录直接拼接进提示词的做法,在交互不断累积、超出上下文窗口后便难以为继。为此,学术界与产业界涌现出检索增强、长期记忆、程序性记忆等大量记忆方案,但它们往往在不同任务、不同协议下各自评测,彼此难以横向比较。
现有评测基准也只覆盖了这一问题的局部。LoCoMo、LongMemEval等文本类基准主要考察对话或文档中的信息保留与检索,却不检验记忆能否支撑工具调用等实际执行。部分新兴的智能体记忆基准虽然走向交互式、跨任务场景,却未能在同一框架下区分"知识型"与"执行型"记忆需求,部分基准还未完全开源。结果是,企业在构建智能体时,面对琳琅满目的记忆方案,缺乏可靠的选型依据。
EvoMemBench突破何在:两大维度、四类场景,构建智能体记忆的"统一度量衡"
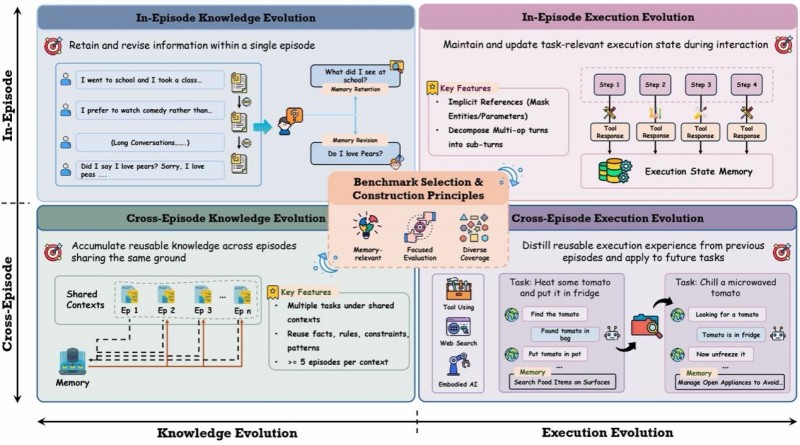
研究团队提出,真正有效的智能体记忆不应只是"存下来",而应能够随着交互持续更新、组织和复用,即"自演化记忆"。基于这一视角,EvoMemBench沿两大维度构建评测体系:
记忆范围:单任务内(In-Episode)记忆服务于当前任务的后续决策;跨任务(Cross-Episode)记忆则从历史任务中沉淀可复用的经验
记忆内容:知识型记忆维护事实、规则、偏好等支撑推理与回答的信息;执行型记忆维护任务进度、工具输出、操作流程等支撑行动的信息
两两组合,形成四类核心评测场景:
任务内知识演化:在长交互中保留并修正信息。用户先说"我爱吃梨",后又更正为"其实是豌豆",智能体能否记对?
任务内执行演化:在多轮工具调用中追踪执行状态。用户说"把报告移到刚才创建的目录",智能体能否记得是哪个目录?
跨任务知识演化:在共享背景的多个任务间,持续积累可复用的事实、规则与规律
跨任务执行演化:从历史任务中提炼可迁移的执行经验。从"加热番茄并放入冰箱"中学到的经验,能否用于"冷藏一个微波加热过的番茄"?
在数据构建上,EvoMemBench遴选并重构了六个数据集,覆盖对话问答、长文档理解、工具调用、网页搜索与具身智能等多元场景,共计五千余个评测样本。针对工具调用任务,研究团队将可从上文推断的实体与参数替换为隐式指代,并将多步操作拆分为相互依赖的子轮次,再经人工校验。这样,评测就更聚焦于"记忆"本身,而非复杂的规划能力。
在评测协议上,研究以DeepSeek-V3.2为统一底座,覆盖五大类共15种代表性记忆方法:检索增强记忆、短期记忆、通用长期记忆、程序性长期记忆与元演化记忆,包括BM25、GraphRAG、Mem0、MemOS、AWM、ReasoningBank、MemEvolve等。这些方法均被封装为统一的"调用—更新"接口,并与Gemini-3-Flash、GPT-5-mini、DeepSeek-V3.2三个长上下文大模型同台对比。除准确率与任务成功率外,研究还同步统计token消耗与执行步数,并考察16K至128K不同上下文预算以及跨环境迁移表现,兼顾效果与成本。
核心发现:记忆不是"越多越好",而是"恰如其分"
大规模实验揭示了当前智能体记忆的真实图景:
发现一:强大的长上下文模型依然是"硬核对手"。 在任务内知识演化场景中,不借助外部记忆的Gemini-3-Flash在信息保留与信息修正两项上均排名第一。当上下文预算充足时,直接保留原始证据往往比依赖外部记忆抽象更可靠。
发现二:上下文越紧张,记忆越有价值。 在多轮工具调用任务中,与DeepSeek-V3.2基线相比,最佳记忆方法在16K和32K上下文预算下分别提升14.5和14.0个百分点。当预算扩大到64K和128K时,提升收窄至7.8和8.5个百分点。128K下部分记忆方法甚至低于基线,因为冗余的记忆内容反而会挤占宝贵的上下文空间。
发现三:难题方见真章。 在跨任务知识演化场景中,面对简单任务,不加记忆的DeepSeek-V3.2准确率为52.1%,最佳记忆方法仅为50.0%。而在困难任务上,基线准确率为0.0%,ACE可将其提升至13.0%。记忆的关键不在于"存了多少",而在于能否将知识组织为可复用、可应用的形式。
发现四:没有"万能记忆"。 不同执行场景偏好不同的记忆形式:
工具调用领域:以BM25、向量检索、GraphRAG为代表的检索增强记忆整体排名最优
网页搜索领域:通用长期记忆表现最佳
具身智能领域:程序性长期记忆更胜一筹
跨环境迁移实验进一步表明,记忆能否迁移,取决于其承载的经验是否与目标任务的决策过程相匹配。
行业意义:为企业级智能体记忆系统绘制"选型地图"
EvoMemBench的价值不仅在于给出一份榜单,更在于为智能体记忆的研发与落地提供了一套可复现、可比较的方法论。对企业客户而言,它具有多重价值:
选型有据:针对知识问答、工具调用、网页检索、具身执行等不同业务场景,明确何种记忆形式更具优势,避免"一套方案打天下"
成本可衡:同步评估token消耗与执行步数,揭示记忆带来的真实开销。例如在跨任务工具调用场景中,部分检索类记忆方法的平均token消耗达到基线模型的3倍以上。这能帮助企业在效果与成本之间做出理性权衡
开放可复现:代码与评测协议全面开源,为学术界与产业界提供公平、透明的统一测试平台
研究结论同样指明了下一代智能体记忆的演进方向:从"被动存储"走向"主动演化"。记忆系统不仅要能存、能取,更要能在新旧证据冲突时正确修正,并将零散经验组织为结构化、可迁移的知识。创邻科技将持续联合学术界与产业伙伴,围绕智能体记忆、图增强推理、企业知识图谱等前沿方向持续探索。我们将构建可信、可控、可持续演进的智能体数据底座,赋能企业在AI Agent时代建立结构性竞争优势。